NumPy
Вычислительные возможности Python. NumPy
Как мы уже говорили, Python — язык для быстрой разработки. Однако чистый Python не предназначен для написания быстрых программ. Это интерпретируемый язык, поэтому программы на Python выполняются медленнее аналогов на C, C++ или Fortran. С другой стороны, математики, физики, биологи и инженеры часто применяют Python для решения вычислительных задач.
Нет ли тут противоречия? Как интерпретируемый язык может быть эффективен в вычислительной математике?
Оказывается, все дело в библиотеках. Python отлично подходит на роль промежуточной среды, оболочки, «клея» между библиотеками, написанными на разных языках.
В этом уроке мы поговорим о наиболее фундаментальной библиотеке для работы с вычислительной математикой — Numpy.
Многие другие пакеты для работы с данными и вычислениями используют базовые объекты этой библиотеки. В числе таких пакетов OpenCV — открытая библиотека для работы с распознаванием образов — и Pandas — библиотека, ориентированная на анализ данных.
Измерение скорости
Замеры времени (а в более общем случае, профилирование) — не такая простая процедура, как может показаться. Обычно проще всего замерить астрономическое время между началом и концом выполнения задачи, усредняя результаты нескольких опытов. Однако почти все ОС многозадачны, поэтому процессор (и его вычислительные ядра) редко отдаются одной задаче в единоличное пользование. Как следствие, в измерениях лучше использовать именно процессорное время. Механизмы замера времени сами вмешиваются в процесс и немного влияют на результат — как и в любом физическом эксперименте.
В Python для замера времени работы кода служит библиотека timeit.
Вы можете познакомиться с возможностями модуля в соответствующем разделе документации.
Например, мы можем замерить три разных способа заполнить список из миллиона квадратных корней.
Как видим, в этой версии интерпретатора (3.7) предпочтительно использовать map.
Tip
В версии интерпретатора 3.12 были произведены оптимизации
Самый медленный способ — это, конечно же, динамическое расширение существующего списка (append). Причем, чем больше список — тем медленнее он меняет свой размер. Это вызвано необходимостью иногда переносить данные из одного места списка в другое.
Несмотря на относительную быстроту (0,15 секунд на извлечение 1 000 000 квадратных корней), скорость можно увеличить еще примерно в 10 раз. Давайте посмотрим как.
Массивы в NumPy
Основной объект в Numpy — многомерный массив.
Массивы — одна из базовых структур данных, которая позволяет моделировать многие объекты, относящиеся как к науке, так и к обычной жизни: список покупок, результаты наблюдения температуры, матрицы и векторы, изображения, видео и т. д. Напомним, что в чистом Python нет типа данных с именем массив, и нам приходится моделировать его с помощью списков.
Другое дело — Numpy. За тип массива здесь отвечает объект array.
Как же создать массив?
Во-первых, массив можно сделать из обычного списка:
Или из диапазона:
А можно сделать и из итератора с помощью функции fromiter():
В Numpy элементы одного массива должны быть однородны (одного типа). Это самое важное идеологическое отличие массивов от списков, в которых можно хранить объекты разной природы.
Numpy создаст массив из юникод-строк длиной 32. За тип элементов в большинстве случаев отвечает параметр dtype(data type). Обратите внимание на тип данных элементов массива.
Посмотрите так же на использование параметра dtype:
Указание типов и работа с ними нужны, поскольку языки, на которых написана эта библиотека, строго типизованы. Вдобавок это увеличивает скорость обработки данных.
Размерность массива
Размерность массива можно в любой момент изменить операцией reshape().
Узнать размерность можно атрибутом shape.
Вообще говоря, размерность — всего лишь «синтаксический сахар». В памяти все может храниться как одномерный массив с пересчетом координат элемента. Таким образом, операция reshape() — просто изменение коэффициентов в алгоритме, а не перераспределение и копирование данных.
array([
    [ 0,  1,  2,  3,  4,  5,  6,  7,  8,  9],
    [10, 11, 12, 13, 14, 15, 16, 17, 18, 19],
    [20, 21, 22, 23, 24, 25, 26, 27, 28, 29],
    [30, 31, 32, 33, 34, 35, 36, 37, 38, 39],
    [40, 41, 42, 43, 44, 45, 46, 47, 48, 49],
    [50, 51, 52, 53, 54, 55, 56, 57, 58, 59],
    [60, 61, 62, 63, 64, 65, 66, 67, 68, 69],
    [70, 71, 72, 73, 74, 75, 76, 77, 78, 79],
    [80, 81, 82, 83, 84, 85, 86, 87, 88, 89],
    [90, 91, 92, 93, 94, 95, 96, 97, 98, 99]
])
array([
    [ 0,  1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19],
    [20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39],
    [40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59],
    [60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71, 72, 73, 74, 75, 76, 77, 78, 79],
    [80, 81, 82, 83, 84, 85, 86, 87, 88, 89, 90, 91, 92, 93, 94, 95, 96, 97, 98, 99]
])
array([
[
  [ 0,  1,  2,  3],
  [ 4,  5,  6,  7],
  [ 8,  9, 10, 11],
  [12, 13, 14, 15],
  [16, 17, 18, 19]
],
[
  [20, 21, 22, 23],
  [24, 25, 26, 27],
  [28, 29, 30, 31],
  [32, 33, 34, 35],
  [36, 37, 38, 39]
],
[
  [40, 41, 42, 43],
  [44, 45, 46, 47],
  [48, 49, 50, 51],
  [52, 53, 54, 55],
  [56, 57, 58, 59]
],
[
  [60, 61, 62, 63],
  [64, 65, 66, 67],
  [68, 69, 70, 71],
  [72, 73, 74, 75],
  [76, 77, 78, 79]
],
[
  [80, 81, 82, 83],
  [84, 85, 86, 87],
  [88, 89, 90, 91],
  [92, 93, 94, 95],
  [96, 97, 98, 99]]])
Например, фильм можно представить в виде 4-мерного массива кадров. Кадр — картинка, то есть трехмерный массив. Его можно представить и как двумерный массив пикселей, где каждый пиксель — одномерный массив из трех элементов: R, G, B.
Самое главное — при использовании функции reshape() произведение ее параметров должно быть равно количеству элементов в массиве.
Иначе мы получим ошибку:
Индексация в массивах
Давайте рассмотрим массив 10×10, созданный ранее.
array([
[ 0,  1,  2,  3,  4,  5,  6,  7,  8,  9],
[10, 11, 12, 13, 14, 15, 16, 17, 18, 19],
[20, 21, 22, 23, 24, 25, 26, 27, 28, 29],
[30, 31, 32, 33, 34, 35, 36, 37, 38, 39],
[40, 41, 42, 43, 44, 45, 46, 47, 48, 49],
[50, 51, 52, 53, 54, 55, 56, 57, 58, 59],
[60, 61, 62, 63, 64, 65, 66, 67, 68, 69],
[70, 71, 72, 73, 74, 75, 76, 77, 78, 79],
[80, 81, 82, 83, 84, 85, 86, 87, 88, 89],
[90, 91, 92, 93, 94, 95, 96, 97, 98, 99]
])
В нем работает привычная индексация.
По аналогии со списками мы можем применять срезы:
Кроме того, доступ можно организовать через списки с индексами:
Но самой удобной альтернативой обычному способу является тот, в котором в качестве «адреса» элемента используется кортеж координат:
Скобки, конечно же, можно опустить:
Массовые операции
В них вся суть. Ускорение, по сравнению с чистым Python, достигается за счет замены цикла обработки в Python вызовом одной функции, внутри которой находится скомпилированный машинный цикл. Чтобы упростить код и ускорить его выполнение, нужно убрать весь поток логики с «пробеганием» по массивам, заменив его вызовами базовых агрегатных функций или операторов.
Инициализация:
array([
    [ 0.,  0.,  0.,  0.,  0.,  0.],
    [ 0.,  0.,  0.,  0.,  0.,  0.],
    [ 0.,  0.,  0.,  0.,  0.,  0.],
    [ 0.,  0.,  0.,  0.,  0.,  0.],
    [ 0.,  0.,  0.,  0.,  0.,  0.]
])
array([0.96373978, 0.73252097, 0.32213768, 0.81560531,0.31843467, 0.51289493, 0.99791928, 0.5999641 , 0.15257882, 0.16074567])
Работают основные операции арифметики, сравнения, причем на всем массиве целиком. И это здорово!
Тригонометрические операции тоже работают, только надо использовать их версии из библиотеки numpy, а не из math:
[0.84147098 0.14112001 0.84147098 0.84147098 0.14112001 -0.7568025 0.90929743 0.14112001 0.14112001 0.14112001]
Вспомним начало этого урока, когда мы говорили о скорости работы.
Решим ту же задачу по вычислению 1 000 000 корней с помощью Numpy и посмотрим, какого ускорения мы добились:
Немного о матрицах
Numpy позволяет очень эффективно работать с двумерными и вообще n-мерными массивами.
Сортировки
Библиотека Numpy предлагает свои функции по сортировке. Давайте посмотрим, как они работают:
Но самое интересное в том, что если в качестве значения параметра axis указать None, то матрица перед сортировкой будет линеаризована, то есть превращена в одномерный массив.
Обратите внимание: подобное поведение характерно не только для функции sort(), но и для многих других функций: min(), sum() и т. д.
Но об этом вы можете почитать самостоятельно на странице с документацией.
Вспомним PIL
Работая с библиотекой PIL, тоже можно использовать средства Numpy. Например, если мы хотим сделать изображение темнее оригинала, можем просто поделить его составляющие, например, на 10:
Игра «Жизнь»
Несколько десятилетий назад Джон Конуэй придумал один из самых известных клеточных автоматов, который назвал игрой «Жизнь». Простота правил сочетается в ней с богатством результатов. Многие компьютерные инженеры хоть раз обращались к программированию и исследованию этой игры, которая послужила интересной моделью для многих отраслей науки.
Клеточный автомат — модель однородного пространства с некоторыми клетками. Каждая клетка может находиться в одном из нескольких состояний и иметь некоторое количество соседей. Задаются правила перехода из одного состояния в другое в зависимости от текущего состояния клетки и ее соседей.
Пространство «Жизни» — бесконечное поле клеток.
Каждая клетка имеет 8 соседей (сверху, снизу, справа, слева и по диагонали). Клетка может иметь два состояния — живое (на клетке стоит фишка) и мертвое (фишки нет).
Правила изменения следующие:
- Если клетка была живой, она выживет, если у нее 2 или 3 соседа. Если соседей 4, 5, 6, 7 или 8, она умирает от перенаселенности, а если 0 или 1 — от одиночества
- Новая клетка рождается в поле, у которого есть ровно 3 соседа
Время в этой игре дискретно и считается поколениями. Все начинается с начальной расстановки фишек (0 поколение), в дальнейшем рассматривается эволюция клеточного пространства в 1, 2, 3 и т. д. поколении. Процессы смерти и рождения происходят одновременно, после чего строится следующее поколение.
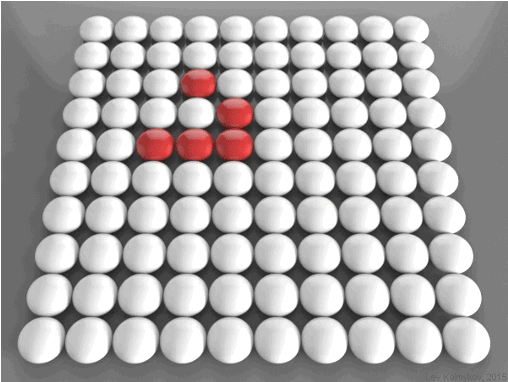
Давайте попробуем написать игру «Жизнь», используя библиотеку Numpy. Пусть у нас будет поле 10×10, в центр которого поместим конструкцию, известную как глайдер. Мы скоро выясним, почему она так называется.
Поле имеет тип uint8, чтобы оно занимало меньше памяти. Каждый его элемент занимает ровно 1 байт (8 бит) и является целым беззнаковым (unsigned) числом в диапазоне от 0 до 255.
Живые клетки обозначаются единицей, а мертвые — нулем. Нужно решить, что делать на границах поля. Мы не можем обеспечить бесконечность в обоих направлениях, поэтому замкнем поле само на себя. Если выйти за нижнюю границу, окажемся наверху, а если за правую — появимся слева, и наоборот. Получается что-то вроде бублика. Такая фигура называется тор.
Для начала познакомимся с операцией roll, доступной для массивов. Она сдвигает исходный массив вдоль одного из измерений (в данном случае — строки или столбца).
array([
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 1, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 1, 0, 0, 0, 0],
    [0, 0, 0, 1, 1, 1, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
], dtype=uint8)
array([
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 1, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 1, 0, 0],
    [0, 0, 0, 0, 0, 1, 1, 1, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
], dtype=uint8)
Мы можем посчитать количество соседей у каждой клетки, просто сделав 8 копий со сдвигом массива и просуммировав их.
Таким образом, матрица количества соседей выглядит так:
array([
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 1, 1, 1, 0, 0, 0, 0],
    [0, 0, 0, 1, 1, 2, 1, 0, 0, 0],
    [0, 0, 1, 3, 5, 3, 2, 0, 0, 0],
    [0, 0, 1, 1, 3, 2, 2, 0, 0, 0],
    [0, 0, 1, 2, 3, 2, 1, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
], dtype=uint8)
Теперь нужно получить новую популяцию.
Выполним на матрице следующую операцию: «если у клетки 3 соседа, то в следующем поколении на этом месте будет клетка; а если 2 — клетка будет при условии, что она была „жива“ в текущем поколении».
Для этого воспользуемся операторами | (или) и & (и).
array([
[False, False, False, False, False, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False],
[False, False, False,  True, False,  True, False, False, False,False],
[False, False, False, False,  True, False, False, False, False,False],
[False, False, False, False,  True, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False],
[False, False, False, False, False, False, False, False, False,False]
], dtype=bool)
array([
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 1, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
], dtype=uint8)
array([
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 1, 0, 1, 0, 0, 0, 0],
    [0, 0, 0, 0, 1, 1, 0, 0, 0, 0],
    [0, 0, 0, 0, 1, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
], dtype=uint8)
Объединить матрицы с логическими и целочисленными элементами можно, поскольку они в данном случае могут быть сведены друг к другу: 0 — False, 1 — True.
Проследим эволюцию глайдера на протяжении четырех поколений. Для этого создадим функцию next_population().
[
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 1 0 0 0 0 0]
    [0 0 0 0 0 1 0 0 0 0]
    [0 0 0 1 1 1 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
]

[
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 1 0 1 0 0 0 0]
    [0 0 0 0 1 1 0 0 0 0]
    [0 0 0 0 1 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
]

[
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 1 0 0 0 0]
    [0 0 0 1 0 1 0 0 0 0]
    [0 0 0 0 1 1 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
]

[
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 1 0 0 0 0 0]
    [0 0 0 0 0 1 1 0 0 0]
    [0 0 0 0 1 1 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
    [0 0 0 0 0 0 0 0 0 0]
]
С визуализацией у нас не очень здорово, но видно, что глайдер «летит»: каждые четыре поколения он сдвигается вниз и вправо. Иными словами, он движется в правый нижний угол.
Почему глайдер не исчезает с поля, а странным образом сначала разбивается на части, а потом материализуется в левом верхнем углу?
Это связано с тем, что фактически мы строим нашу «жизнь» не на плоскости, а на торе. Поэтому, «улетая» вправо, клетка прилетает слева, улетая вверх, прилетает снизу, а углы нашего поля — это одна и та же ячейка.
Задачи
Задача 1
Напишите программу, которая создаёт NumPy-массив из чисел от 0 до 19 и выводит его форму (shape), тип элементов (dtype) и сумму всех элементов.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 2
Напишите программу, которая создаёт матрицу 4×5 из чисел от 0 до 19 с помощью arange и reshape, а затем выводит строку с максимальным значением последнего элемента.
Тест 1:
Ввод:
Вывод:Матрица:
[[ 0 1 2 3 4]
[ 5 6 7 8 9]
[10 11 12 13 14]
[15 16 17 18 19]]
Строка с наибольшим последним элементом: [15 16 17 18 19]
Тест 2:
Ввод:
Вывод:Матрица:
[[ 0 1 2 3 4]
[ 5 6 7 8 9]
[10 11 12 13 14]
[15 16 17 18 19]]
Строка с наибольшим последним элементом: [15 16 17 18 19]
Задача 3
Напишите программу, которая считывает N чисел с одной строки стандартного ввода (через пробел), помещает их в NumPy-массив и выводит: среднее значение, минимум и максимум (каждое на отдельной строке).
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 4
Напишите программу, которая создаёт случайную матрицу 5×5 с целыми числами от 1 до 100 и выводит её транспонированный вариант.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 5
Напишите функцию count_above(arr, threshold), которая принимает NumPy-массив и пороговое значение, и возвращает количество элементов, строго превышающих порог. Используйте векторизованную операцию сравнения.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 6
Напишите программу, которая создаёт матрицу 6×6 из случайных целых чисел от 0 до 20 и сортирует каждую строку по возрастанию. Выведите матрицу до и после сортировки.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 7
Напишите функцию normalize(arr), которая принимает одномерный NumPy-массив и возвращает нормализованный массив, где каждый элемент делится на сумму всех элементов. Используйте только NumPy-операции (без циклов).
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 8
Напишите программу, которая открывает изображение с помощью PIL, переводит его в NumPy-массив и выводит: форму массива, тип данных, среднее значение пикселей по каждому каналу (R, G, B).
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 9
Напишите программу, которая реализует один шаг игры «Жизнь» Конвея. Начальное поле задаётся как двумерный список в коде. Выведите состояние поля до и после одного шага.
Тест 1:
Ввод:
Вывод:Начальное состояние:
[[0 0 0 0 0]
[0 0 1 0 0]
[0 0 1 0 0]
[0 0 1 0 0]
[0 0 0 0 0]]
После шага:
[[0 0 0 0 0]
[0 0 0 0 0]
[0 1 1 1 0]
[0 0 0 0 0]
[0 0 0 0 0]]
Тест 2:
Ввод:
Вывод:Задача 10
Напишите программу, которая запускает симуляцию игры «Жизнь» на N шагов (N вводится с клавиатуры) и после каждого шага подсчитывает количество живых клеток. Выведите номер шага и количество живых клеток в каждом поколении. Начальное поле задайте планером (glider) из урока.
Тест 1:
Ввод:
Вывод:Поколение 0: 5 живых клеток
Поколение 1: 5 живых клеток
Поколение 2: 5 живых клеток
Поколение 3: 5 живых клеток
Поколение 4: 5 живых клеток
Тест 2:
Ввод:
Вывод: